Équilibré et pourtant faux
Un écart de 350,00 euros localisé au journal et à la date, un loyer passé deux fois qui laisse le grand livre équilibré, un libellé vide : trois contrôles SQL.
Dans le cadre de la rubrique « Je partage mes connaissances », je reprends le grand livre de l'article précédent là où nous l'avions laissé : 173 lignes, un écart global de 350,00 euros, et un compte de locations qui affiche 3 200,00 de trop. Deux questions restent ouvertes. Où se trouvent les 350,00 euros ? Et comment un fichier peut-il être équilibré tout en étant faux ?
La base est celle de l'article précédent : les tables ecritures et plan_comptes, chargées dans DB Browser for SQLite. Si vous partez de zéro, la mise en place y est décrite en cinq gestes.
Du « combien » au « où »
Le premier contrôle a dit qu'il manquait 350,00 euros au crédit. Il n'a pas dit où. Sur un grand livre de plusieurs milliers de lignes, cette réponse ne sert à rien tant qu'elle ne pointe pas une écriture.
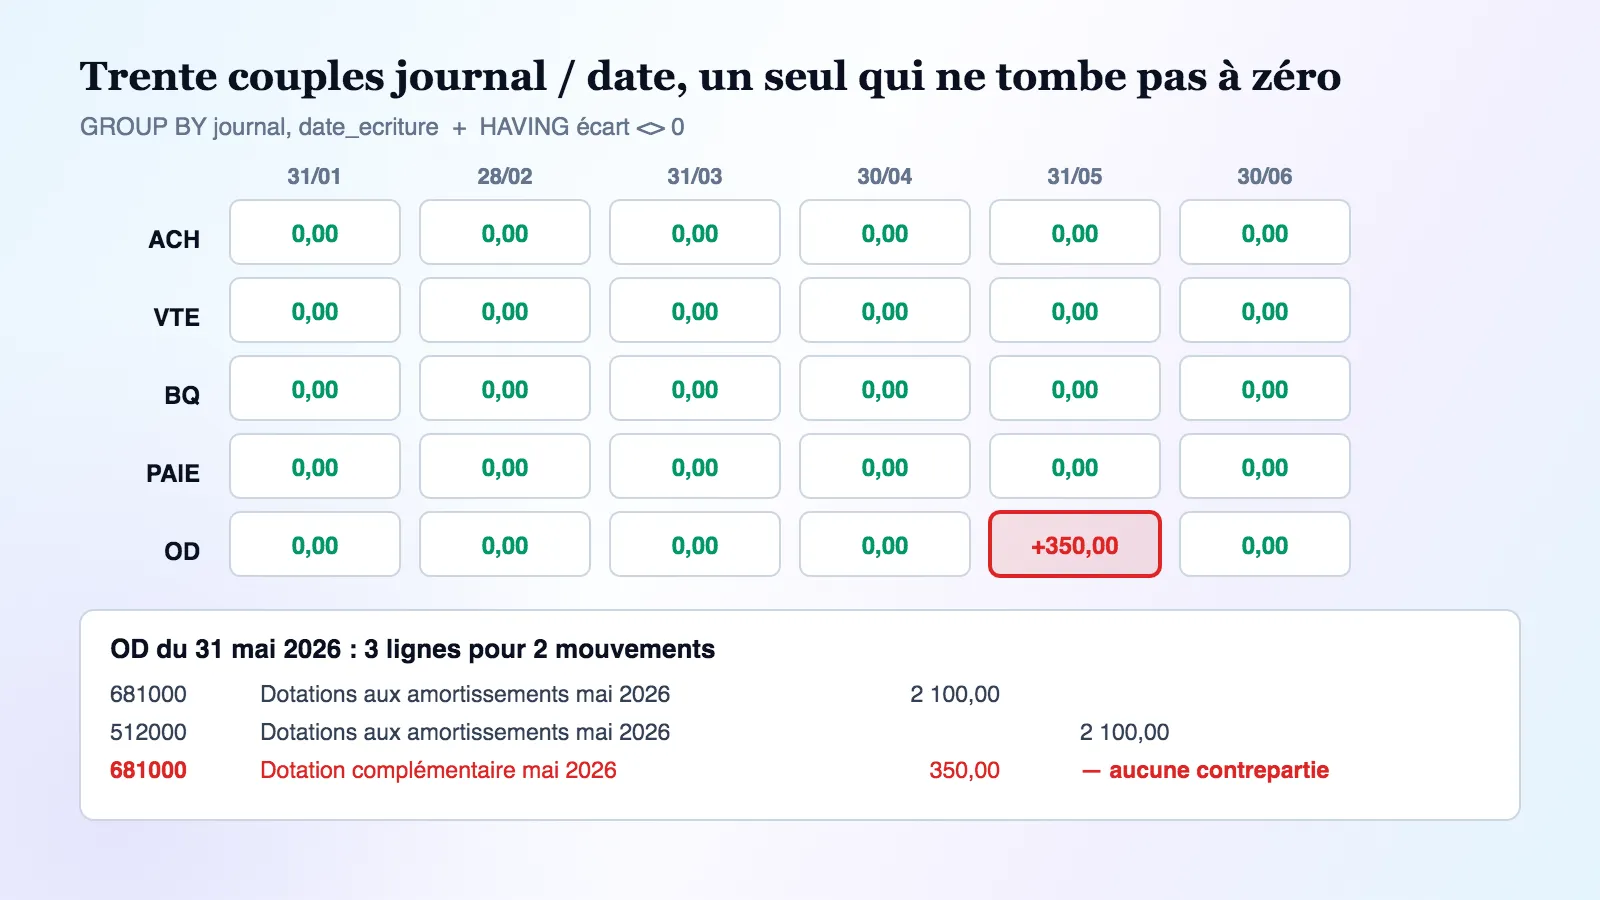
La bonne maille de recherche est connue : une écriture équilibrée l'est à l'intérieur d'un journal et d'une date. Si l'on regroupe les lignes par journal et par date, chaque groupe doit tomber à zéro. Celui qui ne tombe pas à zéro contient le défaut.
Le cas
Trouver le ou les couples journal / date dont le total débit ne correspond pas au total crédit. Le fichier en compte 30 ; la requête ne doit renvoyer que les fautifs, le plus gros écart en premier.
La démarche
- Grouper par
journal, date_ecriture. - Calculer l'écart dans le SELECT, comme au premier contrôle.
- Filtrer les groupes avec HAVING, pas avec WHERE. La condition porte sur une somme, donc sur un groupe : WHERE agit avant le regroupement, sur les lignes, et ne peut pas l'exprimer.
- Arrondir à deux décimales avant de comparer, pour ne pas voir apparaître de faux écarts à 0,000001.
- Trier par écart absolu décroissant, puis F5.
SELECT journal,
       date_ecriture,
       ROUND(SUM(debit), 2) AS total_debit,
       ROUND(SUM(credit), 2) AS total_credit,
       ROUND(SUM(debit) - SUM(credit), 2) AS ecart
FROM ecritures
GROUP BY journal, date_ecriture
HAVING ROUND(SUM(debit) - SUM(credit), 2) <> 0
ORDER BY ABS(SUM(debit) - SUM(credit)) DESC;
Ce que vous devez obtenir
| journal | date_ecriture | total_debit | total_credit | ecart |
|---|---|---|---|---|
| OD | 2026-05-31 | 2 450,00 | 2 100,00 | 350,00 |
Une ligne sur trente. Il suffit ensuite de lister ce groupe pour lire le défaut :
SELECT compte, libelle, debit, credit
FROM ecritures
WHERE journal = 'OD' AND date_ecriture = '2026-05-31';| compte | libelle | debit | credit |
|---|---|---|---|
| 681000 | Dotations aux amortissements mai 2026 | 2 100,00 | 0,00 |
| 512000 | Dotations aux amortissements mai 2026 | 0,00 | 2 100,00 |
| 681000 | Dotation complémentaire mai 2026 | 350,00 | 0,00 |
Trois lignes pour deux mouvements. La dotation de 2 100,00 a sa contrepartie. La dotation complémentaire de 350,00 n'en a jamais reçu. Les 350,00 de l'écart global sont entièrement là, et ils gonflent au passage le compte 681000 : 12 950,00 dans la balance, 12 600,00 sans cette ligne.
Le réflexe à garder : un contrôle global, puis un contrôle groupé, dans cet ordre. Le premier dit s'il faut chercher, le second dit où. Écrire seulement le premier, c'est transmettre un problème sans son adresse.
Équilibré, et pourtant faux
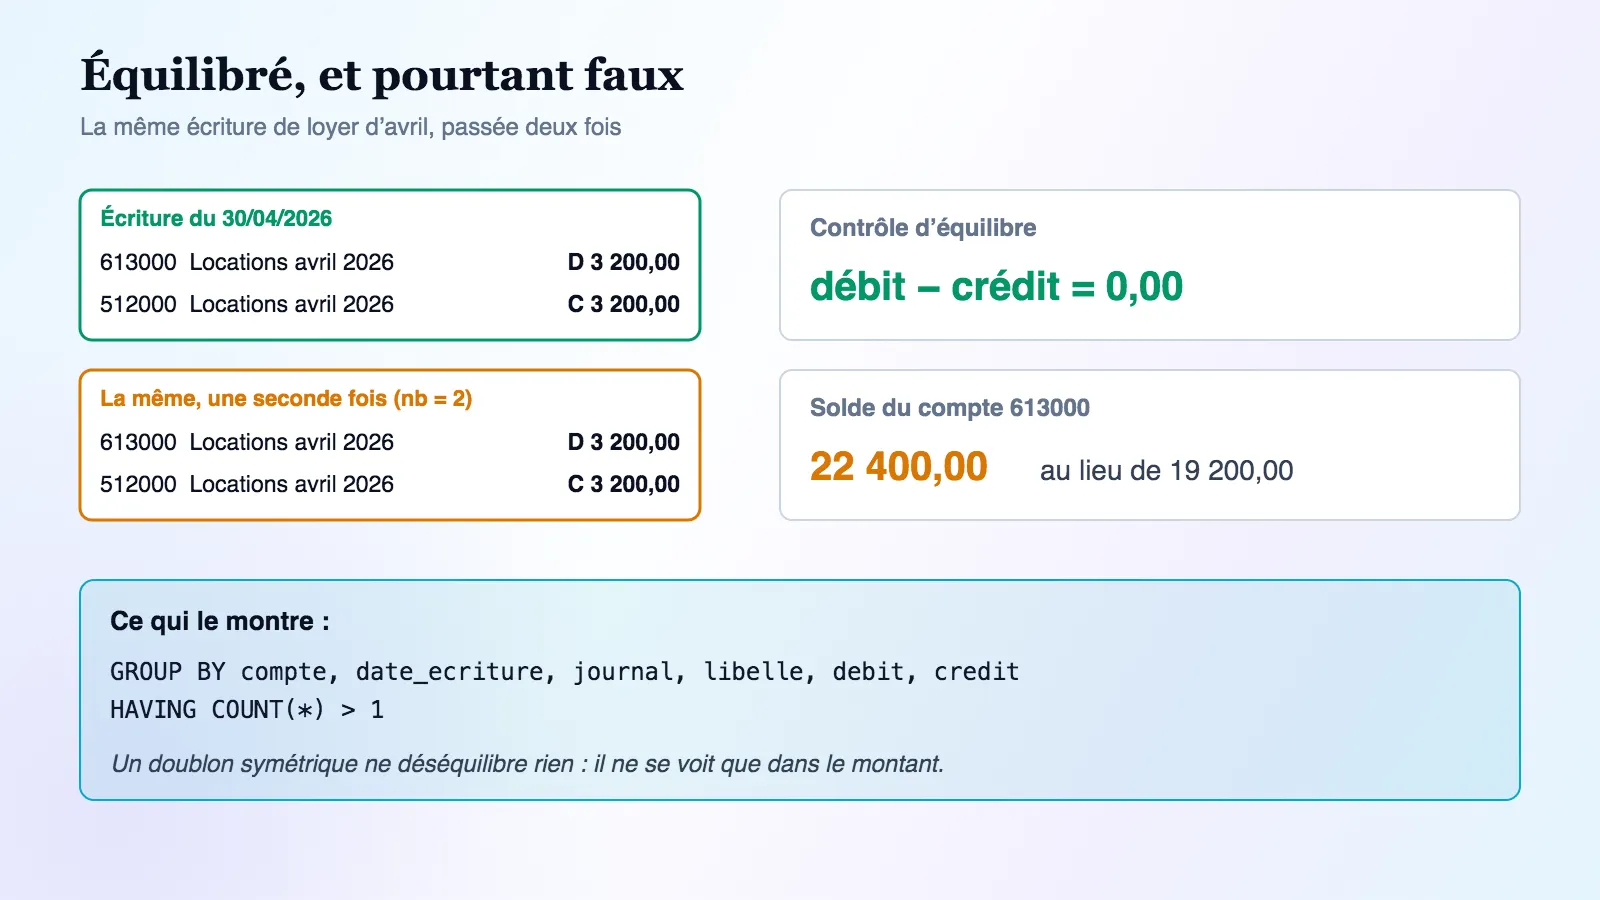
La balance affichait 22 400,00 pour le compte 613000 Locations, alors que le loyer est de 3 200,00 par mois, soit 19 200,00 sur le semestre. Le contrôle d'équilibre que nous venons d'écrire n'a rien signalé sur ce compte. C'est normal, et c'est précisément le problème.
Le cas
Trouver les lignes strictement identiques présentes plus d'une fois dans le grand livre.
La démarche
- Poser la définition avant d'écrire : strictement identique veut dire identique sur toutes les colonnes. Le GROUP BY porte donc sur les six colonnes.
- Garder les groupes qui comptent plus d'une ligne :
HAVING COUNT(*) > 1. - Afficher
COUNT(*)pour savoir combien d'exemplaires existent : deux, trois ou dix, ce n'est pas la même histoire. - Ne rien supprimer. Un doublon se signale à la comptabilité ; il ne s'efface pas dans le fichier de quelqu'un d'autre.
SELECT compte, date_ecriture, journal, libelle, debit, credit,
       COUNT(*) AS nb
FROM ecritures
GROUP BY compte, date_ecriture, journal, libelle, debit, credit
HAVING COUNT(*) > 1
ORDER BY compte;
Ce que vous devez obtenir
| compte | date_ecriture | journal | libelle | debit | credit | nb |
|---|---|---|---|---|---|---|
| 512000 | 2026-04-30 | ACH | Locations avril 2026 | 0,00 | 3 200,00 | 2 |
| 613000 | 2026-04-30 | ACH | Locations avril 2026 | 3 200,00 | 0,00 | 2 |
C'est une écriture entière qui a été passée deux fois, ses deux moitiés avec elle. Le débit et le crédit ont augmenté du même montant : l'équilibre est intact, le contrôle groupé ne voit rien. Seul le montant du compte trahit l'erreur. Un jeu de données peut être parfaitement équilibré et parfaitement faux.
Le libellé qui manque
Un troisième défaut ne se voit ni dans l'équilibre ni dans les montants : une ligne dont on connaît le compte, la date et la somme, mais pas la nature.
Le cas
Lister les lignes sans libellé, sans se laisser piéger par la différence entre une valeur absente et une chaîne vide.
La démarche
- Tester les deux formes d'absence. Selon l'outil et ses réglages d'import, un libellé vide arrive soit comme NULL, soit comme une chaîne vide : un test sur NULL seul peut ne rien renvoyer du tout.
- Ajouter TRIM pour attraper un libellé qui ne contiendrait que des espaces.
SELECT compte, date_ecriture, journal, debit, credit
FROM ecritures
WHERE libelle IS NULL OR TRIM(libelle) = ''
ORDER BY compte, date_ecriture;
Ce que vous devez obtenir
| compte | date_ecriture | journal | debit | credit |
|---|---|---|---|---|
| 606100 | 2026-06-30 | ACH | 1 580,00 | 0,00 |
Le montant est là, la date est là, la nature de la dépense a disparu. Pour une pièce de 1 580,00 euros en fournitures, c'est la question que posera le premier contrôle externe.
Les erreurs qui coûtent une soirée
- WHERE à la place de HAVING. Une condition sur SUM ou COUNT placée dans le WHERE est refusée par le moteur. L'inverse, une condition de ligne mise dans le HAVING, fonctionne mais fait travailler le moteur pour rien.
- S'arrêter au contrôle d'équilibre. Il laisse passer toute une famille d'erreurs : doublons symétriques, montants saisis au mauvais compte, libellés vides. Un jeu de contrôles digne de ce nom teste l'équilibre, les doublons et la qualité des champs.
- Définir un doublon sur trop peu de colonnes. Deux loyers de 3 200,00 le même jour sur deux comptes différents ne sont pas un doublon. Un doublon parfait se définit sur toutes les colonnes ; un « quasi-doublon » demande une autre requête et une autre prudence.
- Tester NULL seul sur du texte importé. Un champ vide venu d'un CSV est souvent une chaîne vide, pas un NULL. Testez les deux, ou vous conclurez qu'il n'y a aucun libellé manquant.
Trois défauts localisés, trois phrases courtes à adresser à la comptabilité : une dotation de 350,00 sans contrepartie au 31 mai, un loyer d'avril passé deux fois, une pièce de 1 580,00 sans libellé au 30 juin. Aucun n'a été rectifié dans l'outil : ils ont été montrés.
La série continue avec le compte de résultat du semestre, sorti en une requête et accompagné des réserves que ces trois défauts imposent : le résultat qui ne part jamais seul. Pour revoir comment la balance en LEFT JOIN a fait apparaître le compte hors plan : le compte que la jointure faisait disparaître.
Versions : article rédigé d'après DB Browser for SQLite 3.13.1, la version proposée au téléchargement sur sqlitebrowser.org (interface en français). Les requêtes sont du SQL standard et s'exécutent à l'identique dans PostgreSQL ou DuckDB ; le traitement des champs vides à l'import d'un CSV peut varier d'un outil et d'une version à l'autre.