Le montant qui n'était pas un nombre
Un export de 174 écritures, propre à l'écran : lu sans précaution par pandas, il perd 307 510,00 de débits. Lire en texte, compter, convertir à côté.
Dans le cadre de la rubrique « Je partage mes connaissances », je vous propose de lire avec pandas un export d'écritures qui a l'air propre et ne l'est pas. Le fichier compte 174 lignes, six colonnes, le premier semestre 2026. Ouvert dans un tableur, il ne montre rien d'anormal. Lu sans précaution, il fait disparaître 307 510,00 de débits sans afficher la moindre erreur.
Les fichiers du cas - série Python pour la finance
Pourquoi lire un export avant de le convertir
Le réflexe, c'est d'ouvrir le CSV dans Excel, de vérifier que les colonnes tombent bien, puis de lancer les totaux. Le tableur interprète chaque cellule à sa façon, et cette interprétation ne se voit pas.
pandas permet l'inverse : tout lire comme du texte, constater, puis convertir colonne par colonne, en comptant ce qui passe et ce qui ne passe pas. Chaque conversion devient une règle écrite, rejouable le mois suivant, et défendable devant quelqu'un qui demande d'où vient un chiffre.
Un fichier reçu ne se corrige jamais à la main. Toute correction est du code, et le fichier d'origine reste intact.
Le vocabulaire, avant de lancer quoi que ce soit
- DataFrame : un tableau, l'équivalent d'une feuille. Chaque colonne est une Series.
- Index : l'étiquette de chaque ligne. Les opérations s'alignent sur l'index, jamais sur la position à l'écran.
- dtype : le type d'une colonne tel que pandas le voit. Texte, nombre, date.
- NaN : une valeur manquante. Ce n'est pas un zéro, et la différence compte.
Regarder avant de convertir
Le cas
Nous recevons ecritures_brut_2026_s1.csv, sans documentation. Avant toute transformation, il faut savoir combien de lignes il contient, comment pandas voit chaque colonne, et où se trouvent les vides.
La démarche
- Lire le fichier en texte intégral. Le séparateur d'un export français est le point-virgule.
- Appeler, dans cet ordre :
shape,head(10),dtypes,isna().sum(). - Compter les journaux et les numéros de compte distincts.
import pandas as pd

gl = pd.read_csv("ecritures_brut_2026_s1.csv", sep=";", dtype=str, encoding="utf-8")
gl.shape
gl.head(10)
gl.dtypes
gl.isna().sum()
gl["journal"].value_counts()
gl["compte"].nunique()
Ce que vous devez obtenir
| Contrôle | Valeur attendue |
|---|---|
gl.shape | (174, 6) |
| Types | texte pour les six colonnes, y compris débit et crédit |
| Valeurs manquantes | libellé 1, débit 1, crédit 1, le reste 0 |
| Journaux | ACH 65, VTE 48, PAIE 24, BQ 24, OD 13 |
| Comptes distincts, tels qu'exportés | 27 |
Les dix premières lignes suffisent à voir le problème : deux formats de date, des montants écrits avec une espace, un compte exporté en 401000.0, et deux lignes 606100 strictement identiques. Le chiffre de 27 comptes distincts est déjà faux : 401000 et 401000.0 sont le même compte, compté deux fois.
On ne décide rien à ce stade. On constate, et on note ce qu'il faudra traiter.
Deux formats de date dans une seule colonne
Le cas
La colonne date_ecriture mélange 31/01/2026 et 2026-01-31. Il faut une vraie colonne de dates, sans perdre une ligne.
Le réflexe est d'écrire pd.to_datetime(gl["date_ecriture"], dayfirst=True). Sur ce fichier, pandas déduit le format de la première valeur, JJ/MM/AAAA, puis refuse la deuxième ligne et s'arrête. Avec errors="coerce", il ne s'arrête plus : il rend 115 dates vides sur 174, sans message. C'est la version dangereuse.
La démarche
- Convertir avec un seul format et compter ce qui passe.
- Recommencer avec l'autre format.
- Vérifier que les deux comptes font le total des lignes. Sinon, un troisième format existe.
- Combiner : la première conversion, complétée par la seconde là où elle a échoué.
- Garder
date_ecrituretelle quelle. Elle servira à repérer le doublon.
jour_mois = pd.to_datetime(gl["date_ecriture"], format="%d/%m/%Y", errors="coerce")
iso = pd.to_datetime(gl["date_ecriture"], format="%Y-%m-%d", errors="coerce")
gl["date"] = jour_mois.fillna(iso)

gl["date"].isna().sum(), gl["date"].min(), gl["date"].max()
Ce que vous devez obtenir
| Contrôle | Valeur attendue |
|---|---|
| Format JJ/MM/AAAA | 59 lignes |
| Format AAAA-MM-JJ | 115 lignes |
| Somme | 174, le fichier entier |
| Dates vides après combinaison | 0 |
| Intervalle | du 2026-01-31 au 2026-06-30 |
Deux formats explicites valent mieux qu'une détection automatique. Le jour où un troisième format arrive, le contrôle de la somme le signale au lieu de le transformer en vide.
Le montant qui n'était pas un nombre
Le cas
Les montants sont écrits à la française : 12 500,00. Il faut deux colonnes numériques, débit et crédit, et la ligne qui n'a aucun montant ne doit pas devenir un zéro anonyme.
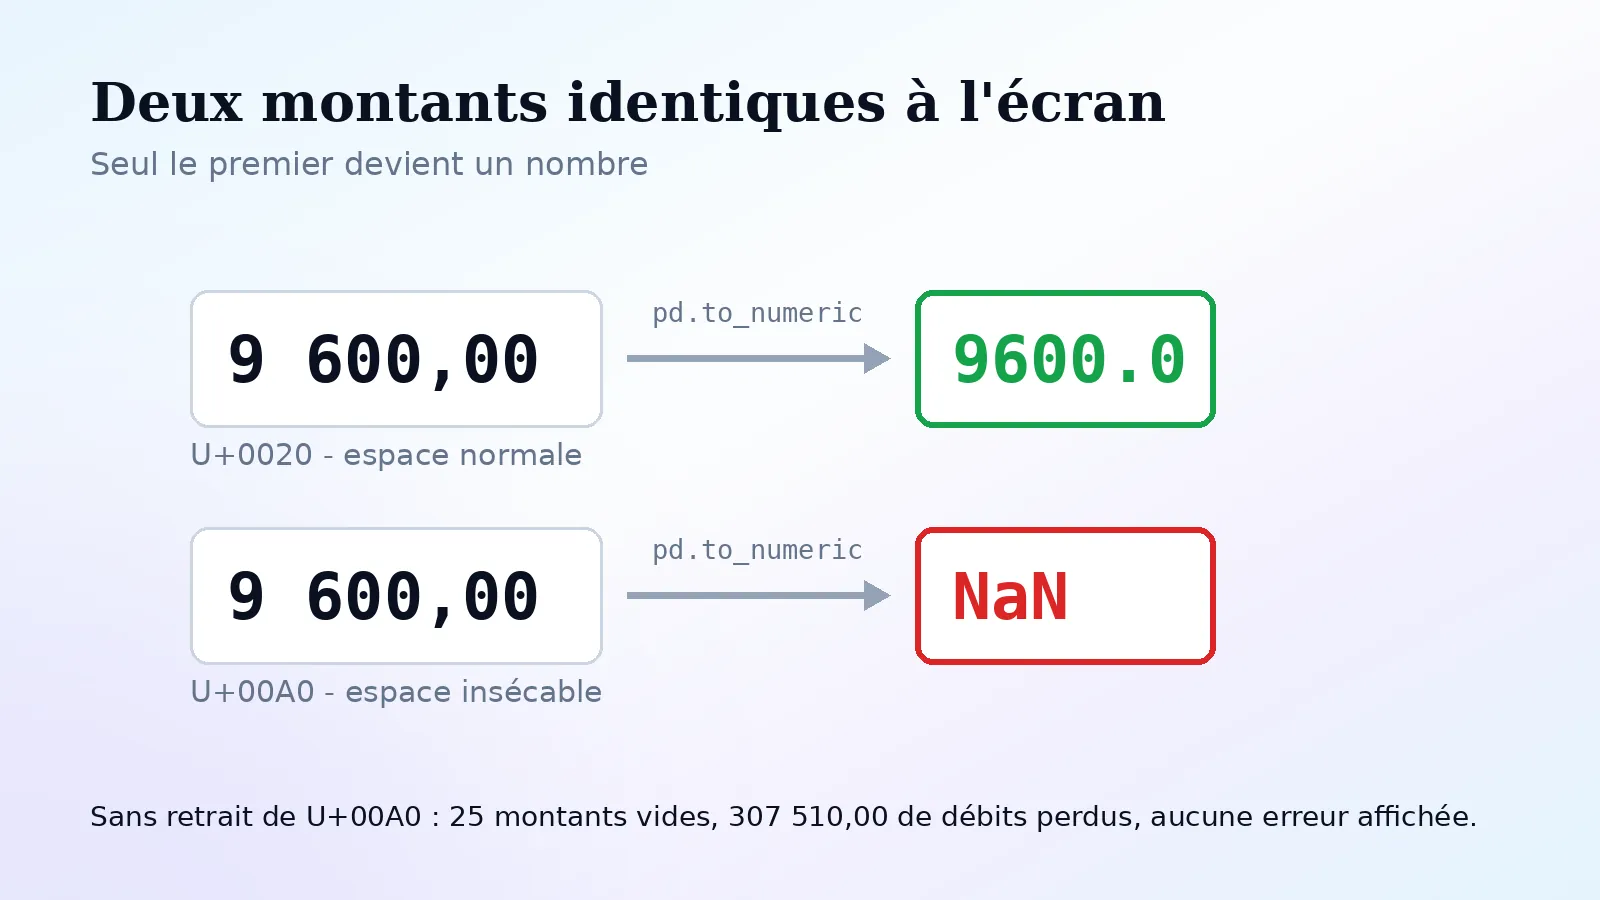
Le piège est invisible. 25 lignes utilisent une espace insécable comme séparateur de milliers, le caractère U+00A0 qui survit à tout copier-coller depuis un PDF. À l'écran, rien ne la distingue d'une espace normale.
La conversion naïve retire les espaces, remplace la virgule par un point, puis convertit. Elle laisse passer les insécables, qui deviennent des valeurs vides. Résultat sur ce fichier :
| Total | Conversion naïve | Conversion correcte | Écart |
|---|---|---|---|
| Débit | 486 460,00 | 793 970,00 | 307 510,00 |
| Crédit | 733 310,00 | 814 270,00 | 80 960,00 |
Aucune erreur, aucun avertissement. Seulement deux totaux faux.
La démarche
- Constater le piège avant de le traiter : compter les montants qui contiennent U+00A0.
- Écrire une fonction qui retire l'insécable d'abord, puis l'espace normale, puis remplace la virgule.
- Appliquer la fonction aux deux colonnes.
- Marquer les lignes sans aucun montant AVANT de remplir les vides par zéro.
- Totaliser, puis regarder la ligne marquée.
gl["debit"].str.contains("\u00a0", regex=False).sum()

def en_nombre(colonne):
    propre = (colonne.fillna("")
              .str.replace("\u00a0", "", regex=False)
              .str.replace(" ", "", regex=False)
              .str.replace(",", ".", regex=False)
              .str.strip())
    return pd.to_numeric(propre.replace("", None), errors="coerce")

gl["debit_num"] = en_nombre(gl["debit"])
gl["credit_num"] = en_nombre(gl["credit"])

gl["sans_montant"] = gl["debit_num"].isna() & gl["credit_num"].isna()
gl[["debit_num", "credit_num"]] = gl[["debit_num", "credit_num"]].fillna(0.0)

round(gl["debit_num"].sum(), 2), round(gl["credit_num"].sum(), 2)
Ce que vous devez obtenir
| Contrôle | Valeur attendue |
|---|---|
| Montants avec espace insécable | 25 (13 au débit, 12 au crédit) |
| Débit total | 793 970,00 |
| Crédit total | 814 270,00 |
| Écart débit moins crédit | -20 300,00 |
| Lignes sans montant | 1 : compte 641000, 28/02/2026, journal PAIE, rémunérations du personnel de février |
La balance ne tombe pas, et c'est normal à ce stade. Une partie de l'écart vient de cette ligne vide : les rémunérations de février ont perdu leur montant à l'export. Si l'on avait rempli les vides par zéro avant de les marquer, cette information aurait disparu.
Une valeur manquante se marque avant d'être remplie. Après un fillna, on ne sait plus ce qui était vide.
Les erreurs qui coûtent une soirée
- Lire les montants directement en nombre. Un numéro de compte devient un flottant, et le total se calcule sur ce qui a bien voulu se convertir.
- Laisser pandas deviner le format des dates sur une colonne mixte. Avec
errors="coerce", l'erreur devient du vide silencieux. - Retirer l'espace normale et oublier l'insécable. Le symptôme est un total trop bas, jamais un message.
- Remplir les vides avant de les compter. L'anomalie devient un zéro que personne ne questionnera.
- Écraser la colonne d'origine. La version convertie va dans une colonne à côté, la source reste lisible.
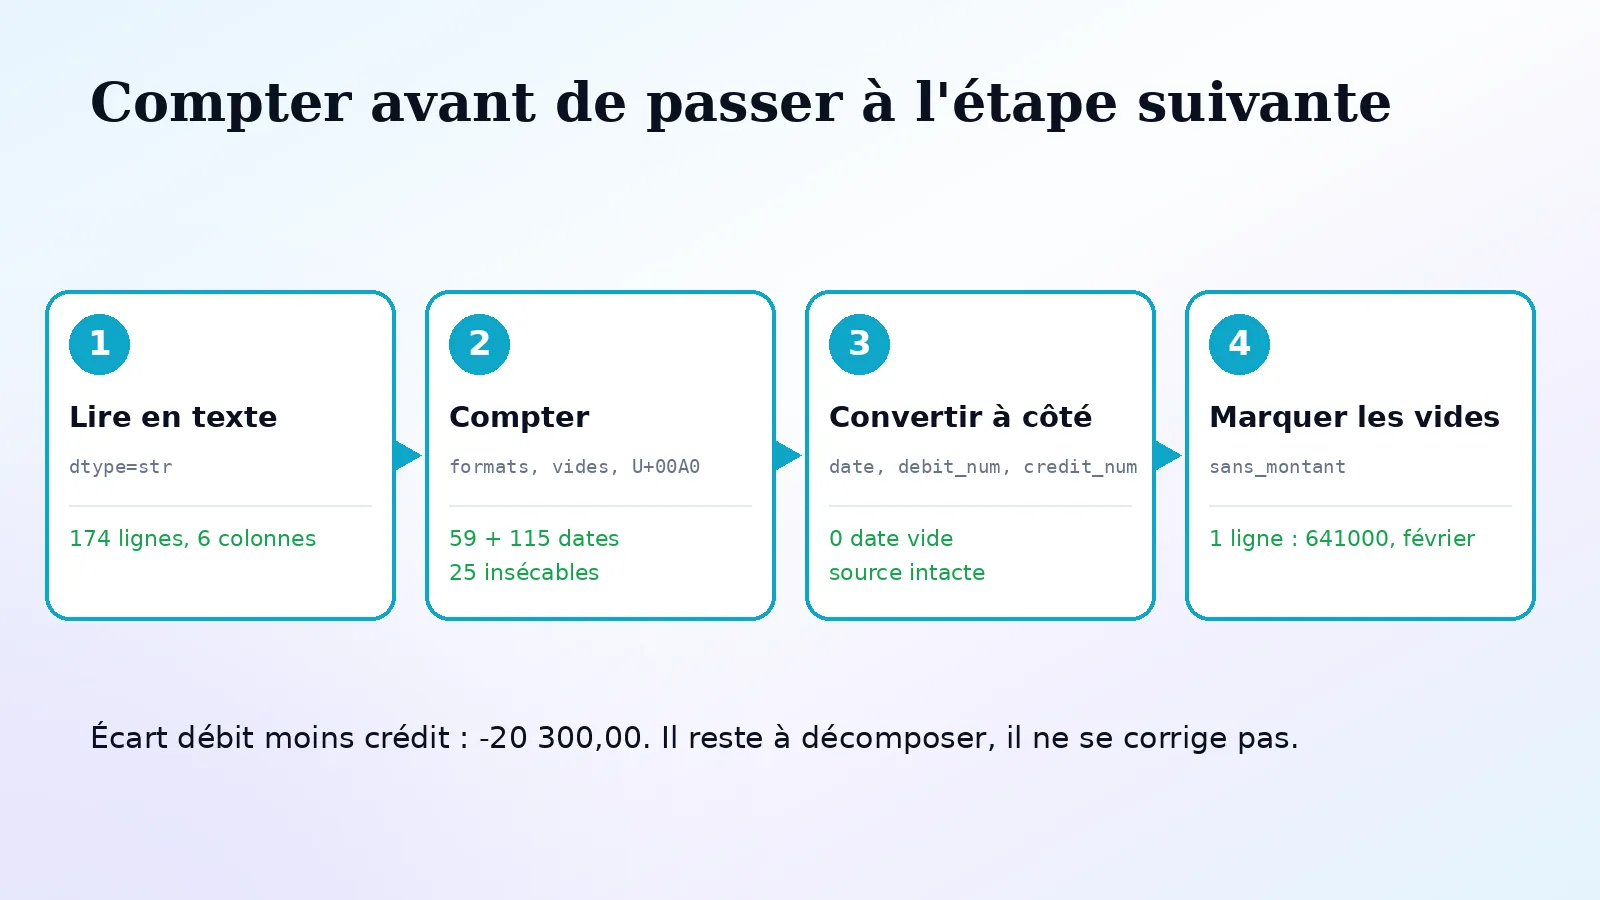
L'écart de -20 300,00 n'est pas expliqué ici. Il se décompose en quatre causes chiffrées, dont une déjà rencontrée en SQL sur le même grand livre. C'est l'objet de l'article suivant.
Le même grand livre, lu en SQL : Le compte que la jointure faisait disparaître.
Versions : article rédigé et vérifié avec Python 3.13, pandas 2.3.3 et pandas 3.0.6 ; les chiffres sont identiques dans les deux versions. Depuis pandas 3.0 (janvier 2026), une colonne lue avec dtype=str s'affiche en type str et non plus object. Les noms de paramètres peuvent évoluer au fil des versions.