Le solde que le total ne raconte pas
Un solde de banque ligne après ligne, le plus gros mouvement de chaque journal ex aequo compris, l'écart au mois précédent : trois fonctions de fenêtrage SQL.
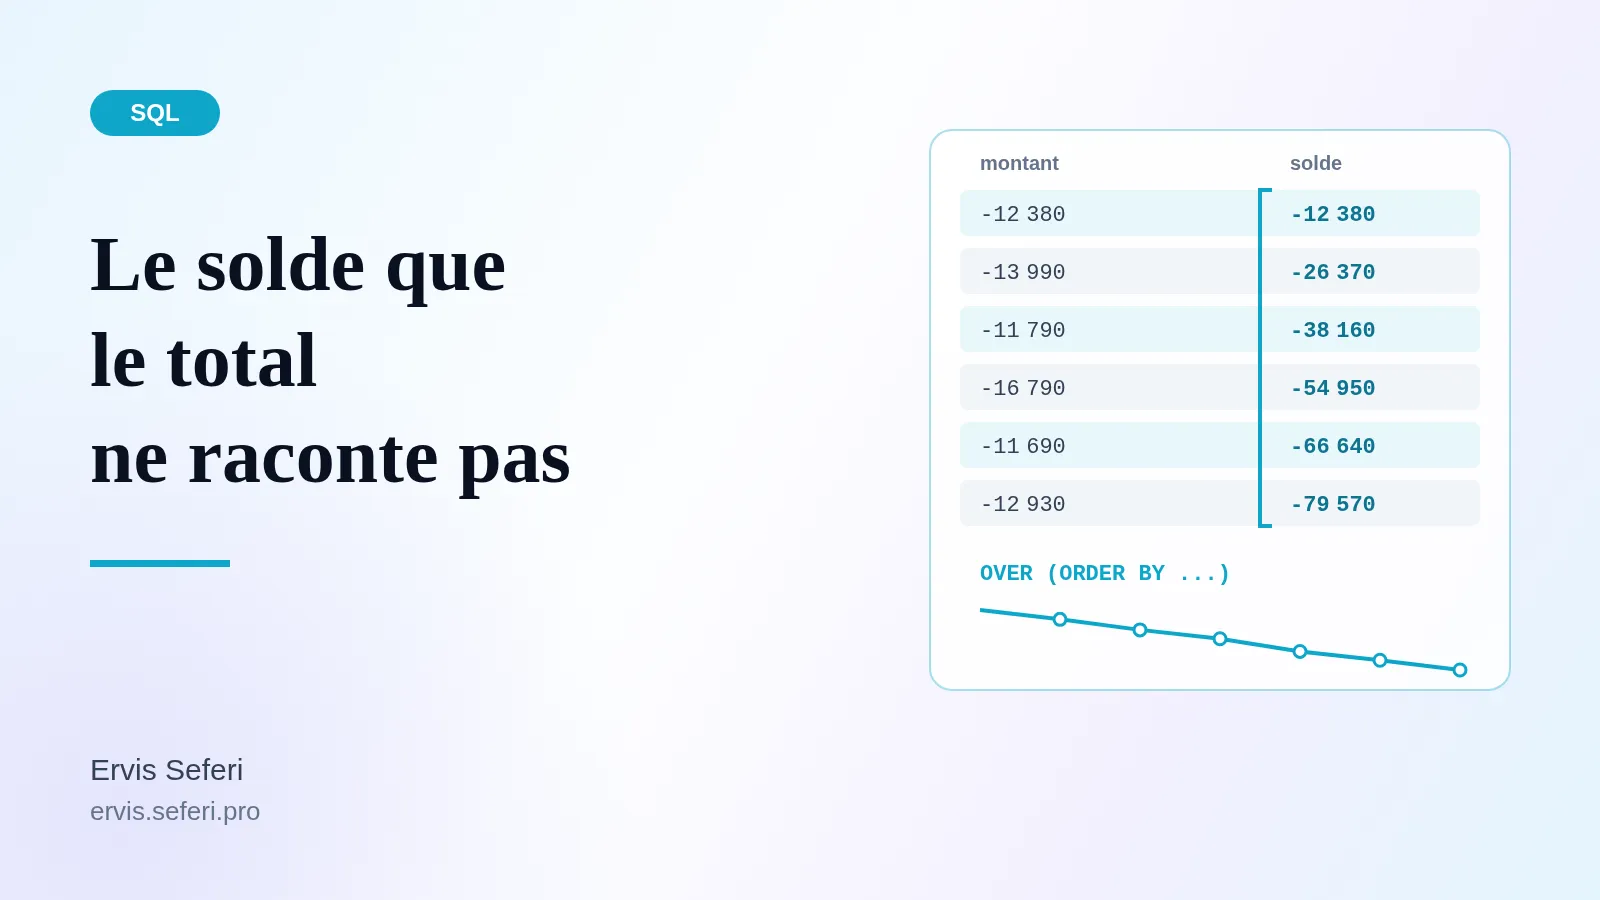
Dans le cadre de la rubrique « Je partage mes connaissances », je vous propose de reprendre le grand livre du premier semestre 2026 pour lui poser trois questions qu'un GROUP BY ne sait pas traiter : comment le solde de la banque a-t-il évolué ligne après ligne, quel est le plus gros mouvement de chaque journal, et de combien un mois s'écarte-t-il du précédent. Les trois réponses tiennent dans une même famille de fonctions, les fonctions de fenêtrage, et dans DB Browser for SQLite.
Les fichiers du cas sont ceux de la série : la table ecritures, 173 lignes, chargée comme dans le premier article. Une base neuve suffit, aucune autre table n'est nécessaire ici.
Ce que le total ne dit pas
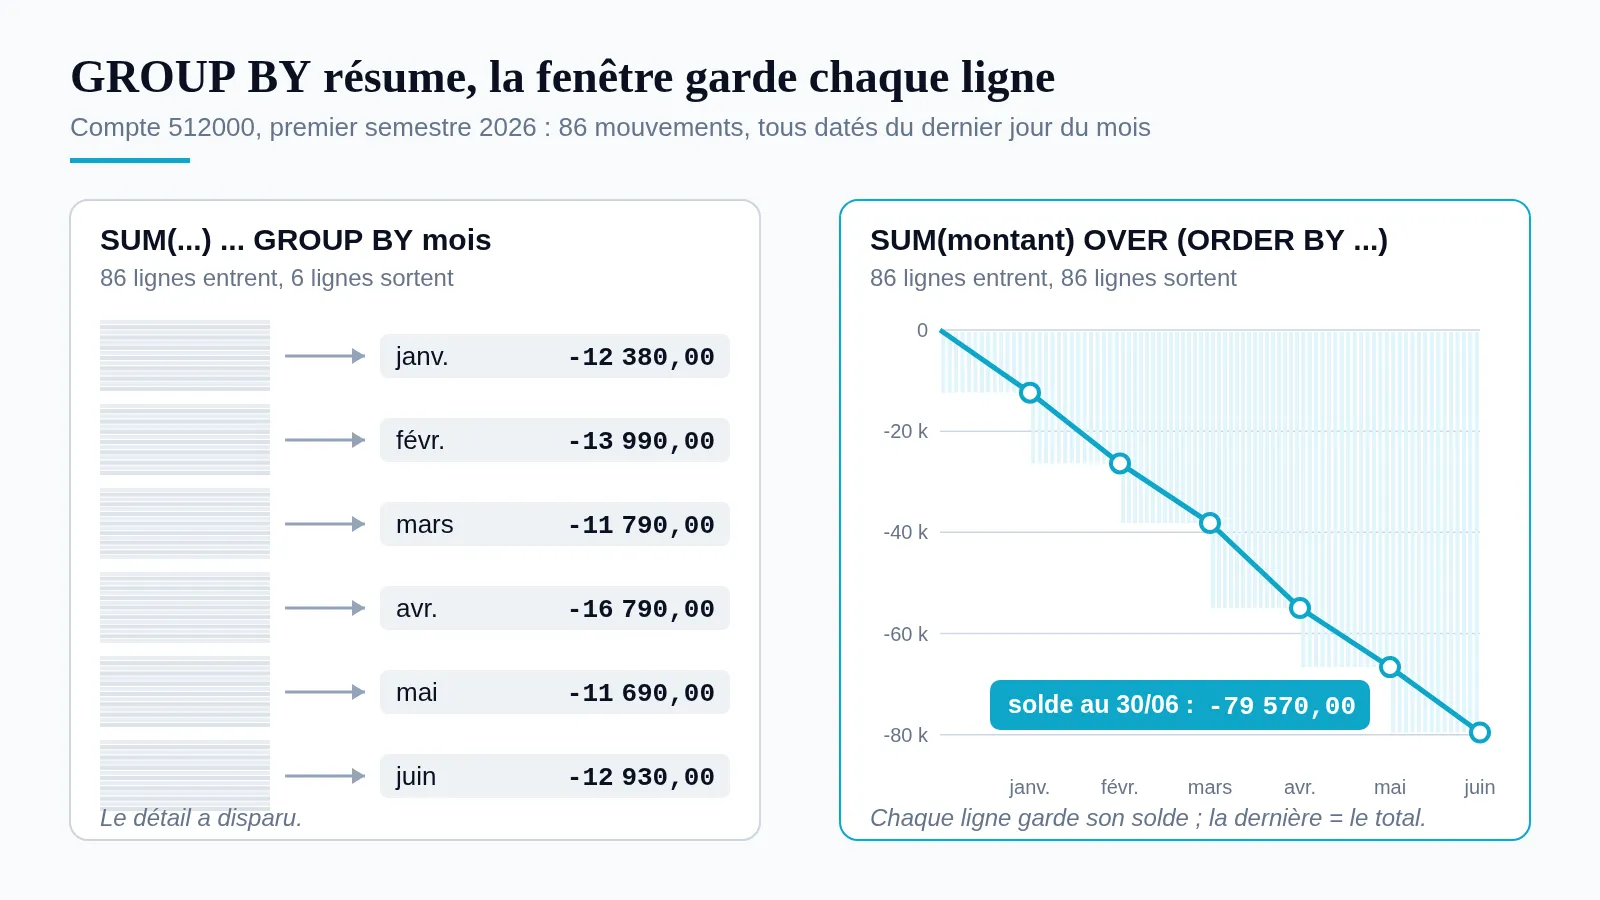
Le compte 512000 (banque) clôture le semestre à -79 570,00. Ce chiffre est juste, et il ne dit presque rien. Il ne dit pas si la trésorerie s'est dégradée d'un coup ou régulièrement, ni quel mois a pesé.
Le réflexe Excel, c'est une colonne de solde où chaque cellule reprend la précédente plus le mouvement. En SQL, le réflexe est un GROUP BY, qui fait l'inverse de ce qu'on cherche : il fusionne les 86 lignes en quelques totaux. La fonction de fenêtrage fait ce que fait la colonne Excel. Elle calcule sur un ensemble de lignes, la « fenêtre », et rend une valeur sur chaque ligne sans en supprimer aucune.
Un deuxième outil rend les requêtes lisibles : la CTE, ou clause WITH. Elle donne un nom à une étape intermédiaire. On isole d'abord les mouvements de banque, on calcule ensuite, et chaque bloc se relit seul.
Le solde, ligne après ligne
Le cas
Afficher, dans l'ordre chronologique, le solde du compte 512000 tel qu'il était après chaque mouvement, sans perdre aucune des 86 lignes.
La démarche
- Onglet Exécuter le SQL. Écrire la CTE
mouvements_banque, qui ne garde que le compte 512000 et calcule un montant signé (débit moins crédit). - Sur cette CTE, ajouter
SUM(montant) OVER (...): la somme se cumule au lieu de regrouper. - Trier la fenêtre par
date_ecriture, id. Toutes les lignes d'un mois portent la même date de fin de mois : sans second critère, l'ordre à l'intérieur d'une date n'est pas garanti. Lerowidde l'import donne un ordre stable. - Écrire une fois la bordure
ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW: « tout depuis le début jusqu'à cette ligne ». C'est le comportement implicite d'unORDER BYseul ; l'écrire, c'est savoir ce que le moteur fait. - F5.
WITH mouvements_banque AS (
  SELECT rowid AS id, date_ecriture, journal, libelle,
         ROUND(debit - credit, 2) AS montant
  FROM ecritures
  WHERE compte = '512000'
)
SELECT date_ecriture, journal, libelle, montant,
       ROUND(SUM(montant) OVER (ORDER BY date_ecriture, id
             ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW), 2) AS solde_progressif
FROM mouvements_banque
ORDER BY date_ecriture, id;
Ce que vous devez obtenir
86 lignes. La dernière ligne de chaque date donne le solde de fin de mois :
| Fin de mois | Solde progressif |
|---|---|
| 31/01/2026 | -12 380,00 |
| 28/02/2026 | -26 370,00 |
| 31/03/2026 | -38 160,00 |
| 30/04/2026 | -54 950,00 |
| 31/05/2026 | -66 640,00 |
| 30/06/2026 | -79 570,00 |
Un cumul complet retombe toujours sur le total simple. Si votre dernière ligne ne donne pas -79 570,00, ne cherchez pas dans les données : c'est presque toujours le tri de la fenêtre qui est faux.
Une précision qui évite une mauvaise lecture. Dans ce fichier, tous les mouvements d'un mois sont datés du dernier jour du mois. Les soldes intermédiaires d'une même date dépendent donc de l'ordre de saisie, pas de l'ordre réel des opérations. Seule la dernière ligne de chaque date a un sens de trésorerie.
Le plus gros mouvement de chaque journal, ex aequo compris
Le cas
Pour chacun des cinq journaux qui mouvementent la banque, sortir le mouvement le plus important en valeur absolue. Quand plusieurs mouvements sont exactement à égalité, les montrer tous.
La démarche
- Reprendre la CTE des mouvements de banque.
PARTITION BY journaldécoupe la fenêtre en cinq groupes indépendants ;ORDER BY ABS(montant) DESCplace le plus gros mouvement en tête de chaque groupe.- Choisir
RANK(), pasROW_NUMBER().RANK()donne le même rang à des valeurs égales.ROW_NUMBER()numérote 1, 2, 3 sans jamais répéter, et tranche donc les égalités arbitrairement. - Filtrer sur le rang dans une seconde CTE. Un rang calculé par une fonction de fenêtrage n'existe pas encore au moment du
WHEREde sa propre requête. - F5.
WITH mouvements_banque AS (
  SELECT date_ecriture, journal, libelle, ROUND(debit - credit, 2) AS montant
  FROM ecritures
  WHERE compte = '512000'
),
classement AS (
  SELECT *, RANK() OVER (PARTITION BY journal ORDER BY ABS(montant) DESC) AS rang
  FROM mouvements_banque
)
SELECT journal, date_ecriture, libelle, montant, rang
FROM classement
WHERE rang = 1
ORDER BY journal, date_ecriture;
Ce que vous devez obtenir
12 lignes, pas 5. Le nombre est la réponse :
| Journal | Lignes au rang 1 | Montant |
|---|---|---|
| ACH | 1 : fournisseurs, 31/03/2026 | 15 200,00 |
| VTE | 1 : ventes de produits finis, 30/06/2026 | 44 600,00 |
| PAIE | 3 ex aequo : rémunérations d'avril, mai et juin | -23 100,00 chacune |
| BQ | 1 : charges d'intérêts, 30/06/2026 | -950,00 |
| OD | 6 ex aequo : les dotations aux amortissements des six mois | -2 100,00 chacune |
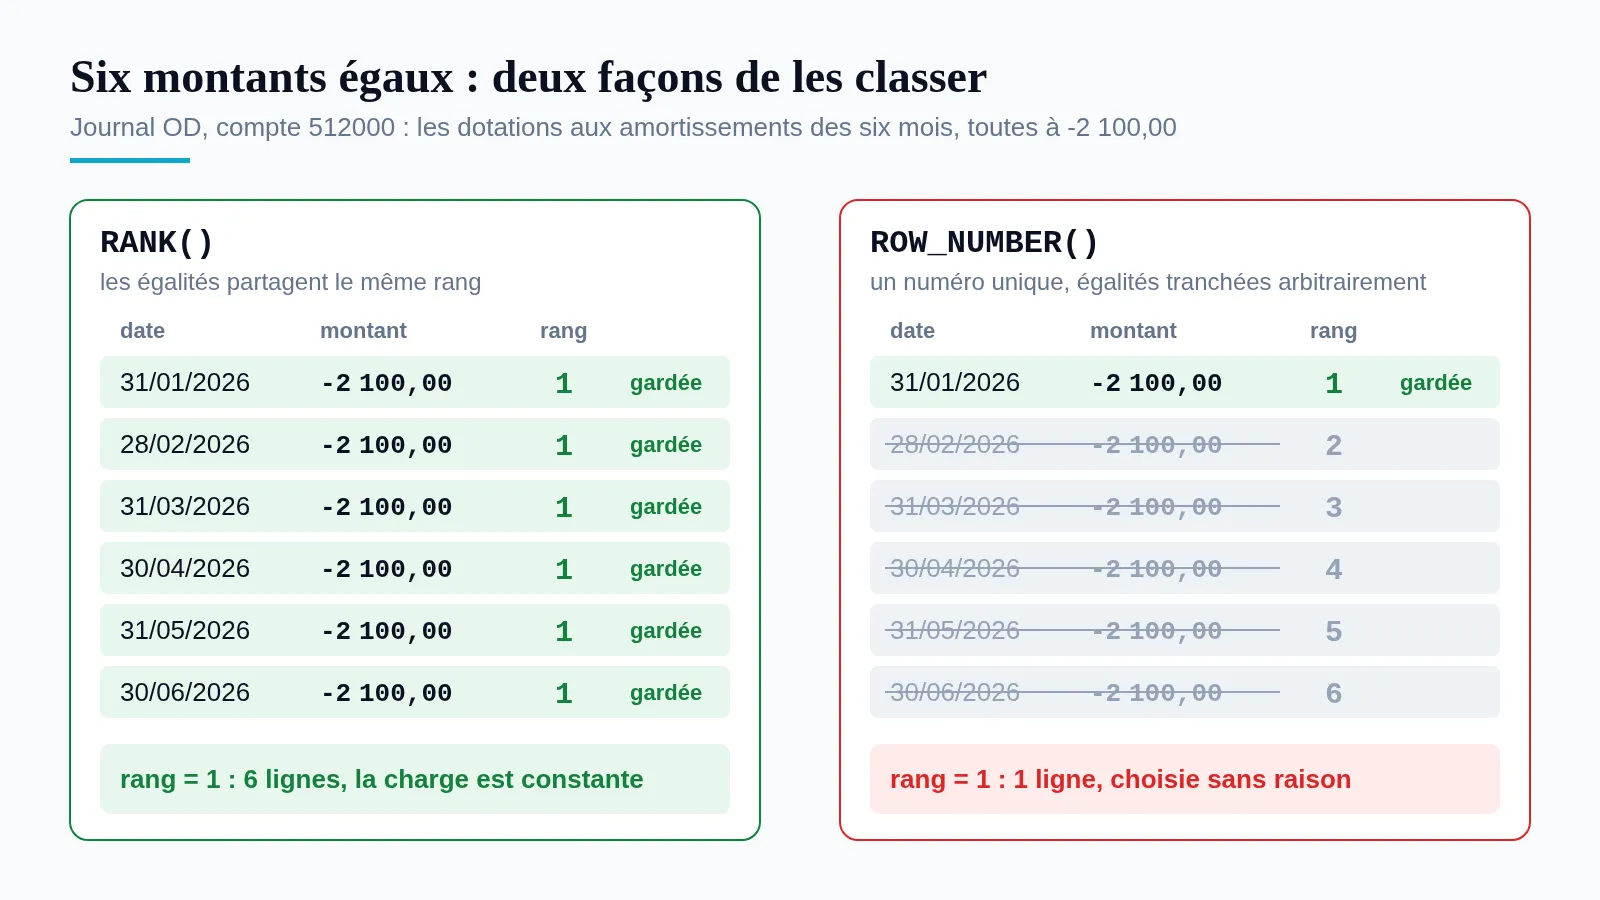
Le journal OD ne porte que des dotations identiques, mois après mois. Avec ROW_NUMBER(), la requête aurait rendu une seule ligne d'OD et caché que la charge ne bouge pas. La question « quel est le plus gros mouvement » admettait six bonnes réponses : la fonction devait pouvoir les rendre.
Ce mois-ci contre le mois dernier, sur la même ligne
Le cas
Le compte 641000 (rémunérations du personnel) bouge une fois sur le semestre. Afficher pour chaque mois le montant, celui du mois précédent et la variation, sans joindre la table à elle-même.
La démarche
- Une CTE isole le compte 641000.
LAG(montant) OVER (ORDER BY date_ecriture)lit la valeur de la ligne précédente et la pose sur la ligne courante. C'est ce qui remplace l'auto-jointure « mois = mois précédent ».- La variation est une soustraction entre la colonne et son
LAG. - Le premier mois n'a pas de prédécesseur :
LAGrend NULL, la variation aussi. C'est le bon comportement. - F5.
WITH remuneration AS (
  SELECT date_ecriture, ROUND(debit - credit, 2) AS montant
  FROM ecritures
  WHERE compte = '641000'
)
SELECT date_ecriture, montant,
       LAG(montant) OVER (ORDER BY date_ecriture) AS montant_mois_precedent,
       ROUND(montant - LAG(montant) OVER (ORDER BY date_ecriture), 2) AS variation
FROM remuneration
ORDER BY date_ecriture;
Ce que vous devez obtenir
| Mois | Montant | Mois précédent | Variation |
|---|---|---|---|
| 31/01/2026 | 22 500,00 | (vide) | (vide) |
| 28/02/2026 | 22 500,00 | 22 500,00 | 0,00 |
| 31/03/2026 | 22 500,00 | 22 500,00 | 0,00 |
| 30/04/2026 | 23 100,00 | 22 500,00 | 600,00 |
| 31/05/2026 | 23 100,00 | 23 100,00 | 0,00 |
| 30/06/2026 | 23 100,00 | 23 100,00 | 0,00 |
Une seule variation, +600,00 en avril, et elle tient ensuite : une hausse durable, pas un accident. Un contrôle mensuel doit faire remonter ce signal sans relire six lignes à l'œil.
La même mécanique s'applique au flux net de la banque, à condition de regrouper d'abord par mois dans une CTE, puis de comparer. Les deux outils s'enchaînent : le GROUP BY résume, la fenêtre compare.
WITH flux AS (
  SELECT substr(date_ecriture, 1, 7) AS mois,
         ROUND(SUM(debit - credit), 2) AS flux_net
  FROM ecritures
  WHERE compte = '512000'
  GROUP BY mois
)
SELECT mois, flux_net,
       LAG(flux_net) OVER (ORDER BY mois) AS mois_precedent,
       ROUND(flux_net - LAG(flux_net) OVER (ORDER BY mois), 2) AS variation
FROM flux
ORDER BY mois;| Mois | Flux net banque | Variation |
|---|---|---|
| 2026-01 | -12 380,00 | (vide) |
| 2026-02 | -13 990,00 | -1 610,00 |
| 2026-03 | -11 790,00 | 2 200,00 |
| 2026-04 | -16 790,00 | -5 000,00 |
| 2026-05 | -11 690,00 | 5 100,00 |
| 2026-06 | -12 930,00 | -1 240,00 |
Avril décroche de 5 000,00 sur mars. Plusieurs postes y contribuent, mais 3 200,00 n'ont jamais quitté la banque : c'est le loyer d'avril saisi deux fois, que le contrôle des doublons avait déjà isolé. Deux méthodes différentes pointent le même mois. Le défaut reste signalé, il n'est pas effacé en silence dans la requête.
Les erreurs qui coûtent une soirée
- Filtrer un rang dans la même requête.
WHERE rang = 1juste aprèsRANK()est refusé : la fenêtre se calcule après leWHERE. Une CTE au-dessus règle la question. - Prendre ROW_NUMBER quand la question admet des égalités. Le résultat a l'air propre et il est incomplet.
- Trier la fenêtre sur la date seule. Avec des dates répétées, deux exécutions peuvent donner deux cumuls intermédiaires différents. Ajoutez toujours un critère qui départage.
- « Corriger » le NULL du premier mois par un zéro. Une variation de 0,00 en janvier affirmerait que décembre valait autant ; le vide dit la vérité : il n'y a pas de mois précédent dans le fichier.
La suite de la série rapproche ce grand livre du relevé bancaire du même semestre, sans clé commune entre les deux fichiers : le doublon que le rapprochement ne voyait pas. Pour revoir comment un GROUP BY localise un écart au journal et à la date : équilibré et pourtant faux.
Versions : article rédigé d'après DB Browser for SQLite 3.13.1, la version proposée au téléchargement sur sqlitebrowser.org (interface en français). Les fonctions de fenêtrage existent dans SQLite depuis la version 3.25.0 (septembre 2018) ; les requêtes sont du SQL standard et s'exécutent à l'identique dans PostgreSQL ou DuckDB.