Deux outils, un seul résultat
Une balance où rien ne disparaît, un résultat apparent de -4 120,00 et trois réserves chiffrées : pandas retombe sur le -23 020,00 obtenu en SQL.
Dans le cadre de la rubrique « Je partage mes connaissances », je vous propose de terminer le traitement du grand livre du premier semestre 2026 avec pandas : produire la balance, en tirer un résultat, et livrer ce résultat avec ses réserves. Les anomalies sont connues et chiffrées. Il reste à construire un livrable qui ne les cache pas, et à vérifier qu'il dit la même chose que le traitement fait en SQL sur le même grand livre.
Les fichiers du cas - série Python pour la finance
Le point de départ est l'état laissé par L'écart qu'on décompose à l'euro : le tableau net de 173 lignes, sans le doublon strict, le plan comptable plan, et la liste a_examiner des doubles trouvés sur les clés normalisées.
Un livrable porte ses réserves
Le réflexe, quand on livre une balance, c'est de livrer des chiffres propres : les anomalies rectifiées, les comptes inconnus rangés quelque part, un total qui tombe. Le lecteur ne voit alors ni ce qui a été rectifié, ni sur quelle hypothèse.
La démarche inverse livre trois choses ensemble : la balance telle que les données la donnent, le résultat qu'on en tire, et la liste des réserves qui pèsent sur ce résultat, chacune chiffrée. Le lecteur décide. Corriger une écriture reste une décision de gestion, pas une option de script.
Un livrable qui énonce ses propres réserves est plus solide qu'un livrable qui les cache.
La balance où rien ne disparaît
Le cas
Il faut une balance par compte, avec le libellé et la classe du plan comptable. Trois comptes mouvementés n'existent pas au plan : 281000, 622600 et 627000. Ils doivent apparaître dans la balance, pas disparaître.
La démarche
- Agréger le grand livre par compte, puis calculer le solde.
- Joindre le plan comptable en
how="left": chaque compte de la balance est conservé, qu'il existe au plan ou non. - Remplacer le libellé manquant par une mention visible, jamais par du vide.
- Déduire la classe manquante du premier chiffre du compte. C'est une hypothèse : elle est écrite comme telle dans le livrable.
- Contrôler avant d'exporter : la somme des soldes doit égaler l'écart du grand livre.
balance = net.groupby("compte_net", as_index=False)[["debit_num", "credit_num"]].sum()
balance["solde"] = (balance["debit_num"] - balance["credit_num"]).round(2)
balance = balance.merge(plan.rename(columns={"Compte": "compte_net"}),
                        on="compte_net", how="left")
balance["Libelle"] = balance["Libelle"].fillna("COMPTE ABSENT DU PLAN COMPTABLE")
balance["Classe"] = balance["Classe"].fillna(balance["compte_net"].str[0])

len(balance), round(balance["solde"].sum(), 2)
(balance["Libelle"] == "COMPTE ABSENT DU PLAN COMPTABLE").sum()
sorted(balance["Classe"].unique())
Ce que vous devez obtenir
| Contrôle | Valeur attendue |
|---|---|
| Comptes dans la balance | 18 |
| Somme des soldes | -21 750,00, l'écart du grand livre après dédoublonnage |
| Comptes absents du plan comptable | 3 : 281000, 622600, 627000 |
| Classes représentées | 5 : 2, 4, 5, 6, 7 |
| Solde du compte 613000, locations | 22 400,00, soit sept loyers de 3 200,00 |
La somme des soldes égale l'écart : la balance n'a perdu aucune ligne en route. Faites l'essai avec une jointure interne. La balance tombe à 15 comptes, la somme des soldes à -23 600,00, et la classe 2 disparaît, puisqu'elle n'existe ici que par le compte 281000, absent du plan. Rien ne signale la perte.
Une jointure qui fait disparaître un compte fait aussi disparaître la question qu'il posait.
Le résultat apparent
Le cas
La balance donne un résultat : les produits de la classe 7 moins les charges de la classe 6. Ce chiffre est calculé sur les données telles qu'elles sont, anomalies comprises. Il faut le produire, et l'appeler par son nom.
La démarche
- Récapituler la balance par classe.
- Sommer les soldes de la classe 6 pour les charges, et ceux de la classe 7, changés de signe, pour les produits.
- Calculer le résultat apparent : produits moins charges.
par_classe = balance.groupby("Classe", as_index=False)[["debit_num", "credit_num", "solde"]].sum()

charges = round(balance.loc[balance["Classe"] == "6", "solde"].sum(), 2)
produits = round(-balance.loc[balance["Classe"] == "7", "solde"].sum(), 2)
resultat_apparent = round(produits - charges, 2)
charges, produits, resultat_apparent
Ce que vous devez obtenir
| Classe | Débit | Crédit | Solde |
|---|---|---|---|
| 2 | 0,00 | 900,00 | -900,00 |
| 4 | 125 800,00 | 72 100,00 | 53 700,00 |
| 5 | 367 550,00 | 446 220,00 | -78 670,00 |
| 6 | 299 170,00 | 0,00 | 299 170,00 |
| 7 | 0,00 | 295 050,00 | -295 050,00 |
Charges 299 170,00, produits 295 050,00 : le résultat apparent est une perte de -4 120,00 sur six mois. Les charges comprennent les 1 850,00 d'honoraires de 622600 et les 900,00 de 627000, classés en charges par leur premier chiffre.
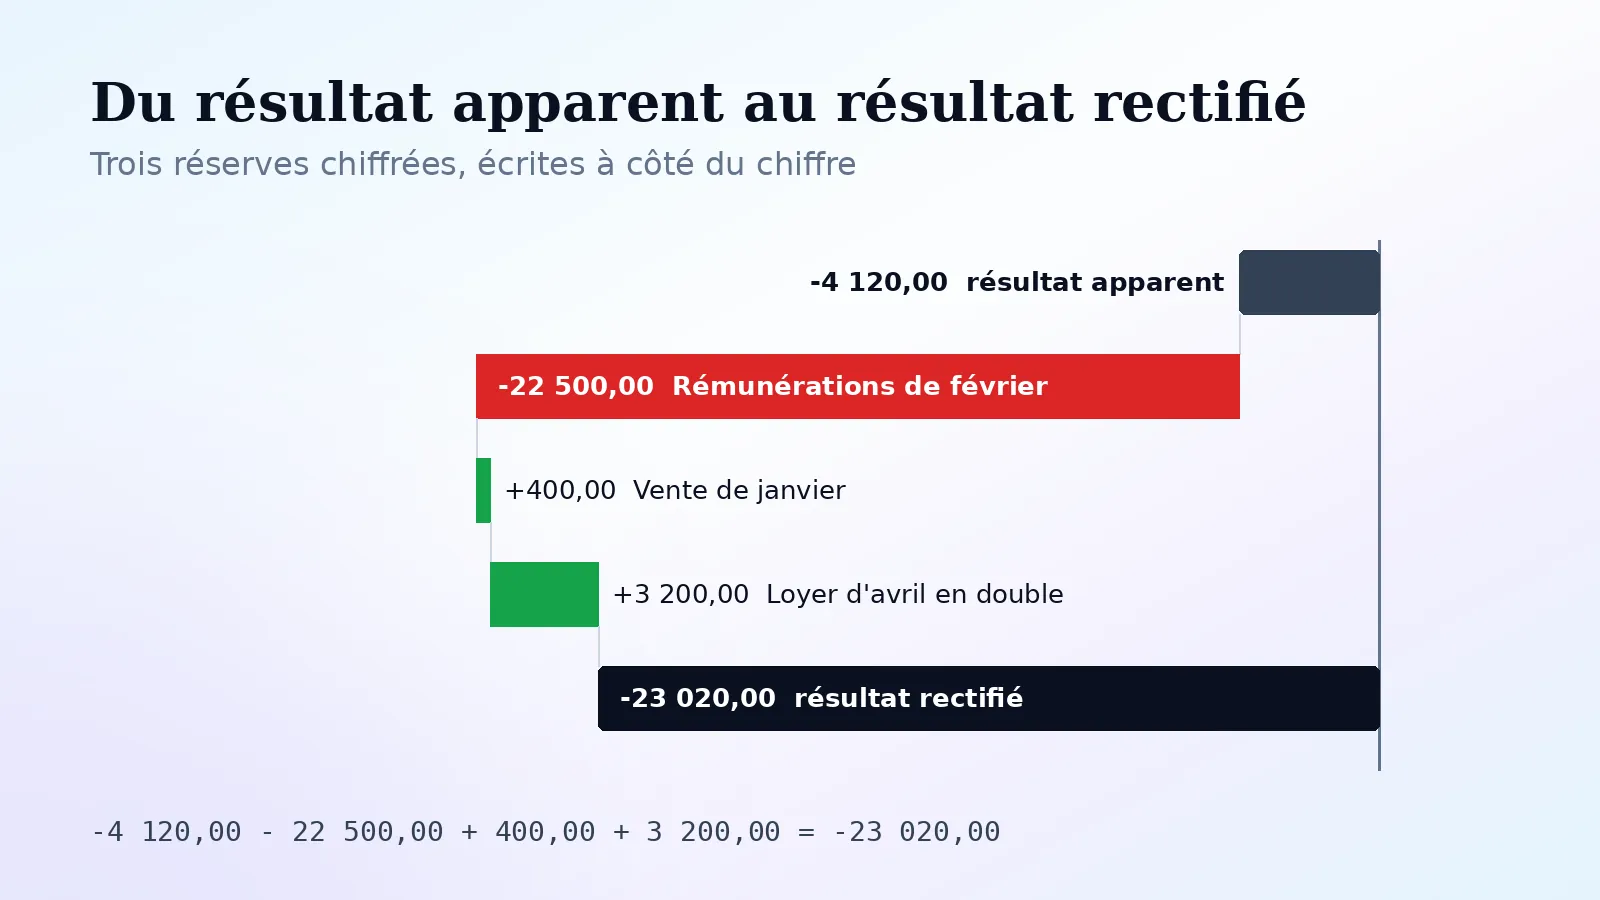
Ce chiffre est faux, et l'on sait déjà de combien. Il manque les rémunérations de février, perdues à l'export. Le loyer d'avril est compté deux fois. La vente de janvier est comptabilisée pour 37 800,00 alors que la banque en a encaissé 38 200,00. Le livrer seul serait livrer une erreur avec l'apparence d'un résultat.
Les réserves, chiffrées à côté du chiffre
Le cas
Chaque anomalie connue qui touche le compte de résultat devient une ligne de réserve : sa cause, le compte concerné, et son effet sur le résultat si elle est confirmée. Le résultat rectifié n'est pas une correction : c'est ce que deviendrait le résultat si les réserves étaient levées dans le sens indiqué.
La démarche
- Écrire les réserves dans un tableau, une ligne par anomalie, avec son effet signé sur le résultat.
- Calculer le résultat rectifié : le résultat apparent plus la somme des effets.
- Garder les deux chiffres côte à côte. Aucun ne remplace l'autre.
reserves = pd.DataFrame([
    ("Rémunérations de février perdues à l'export", "641000", -22500.00),
    ("Vente de janvier : 38 200,00 encaissés, 37 800,00 comptabilisés", "701000", 400.00),
    ("Loyer d'avril compté deux fois", "613000", 3200.00),
], columns=["reserve", "compte", "effet_sur_resultat"])

resultat_rectifie = round(resultat_apparent + reserves["effet_sur_resultat"].sum(), 2)
resultat_apparent, resultat_rectifie
Ce que vous devez obtenir
| Étape | Effet | Résultat |
|---|---|---|
| Résultat apparent | -4 120,00 | |
| Rémunérations de février, 641000 | -22 500,00 | -26 620,00 |
| Vente de janvier, 701000 | +400,00 | -26 220,00 |
| Loyer d'avril compté deux fois, 613000 | +3 200,00 | -23 020,00 |
| Résultat rectifié | -23 020,00 |
-23 020,00, c'est exactement le résultat rectifié obtenu en SQL sur le même grand livre, dans Le résultat qui ne part jamais seul, quand les honoraires de 622600 sont admis en charges. Les deux traitements partent de chiffres apparents très différents, -4 120,00 ici et -24 370,00 en SQL. L'écart de 20 250,00 s'explique entièrement : l'export lu par pandas a perdu les 22 500,00 de rémunérations de février et 400,00 de ventes, et le résultat brut calculé en SQL laissait les 1 850,00 de 622600 hors des charges. Les deux se rejoignent à l'euro une fois chaque réserve écrite.
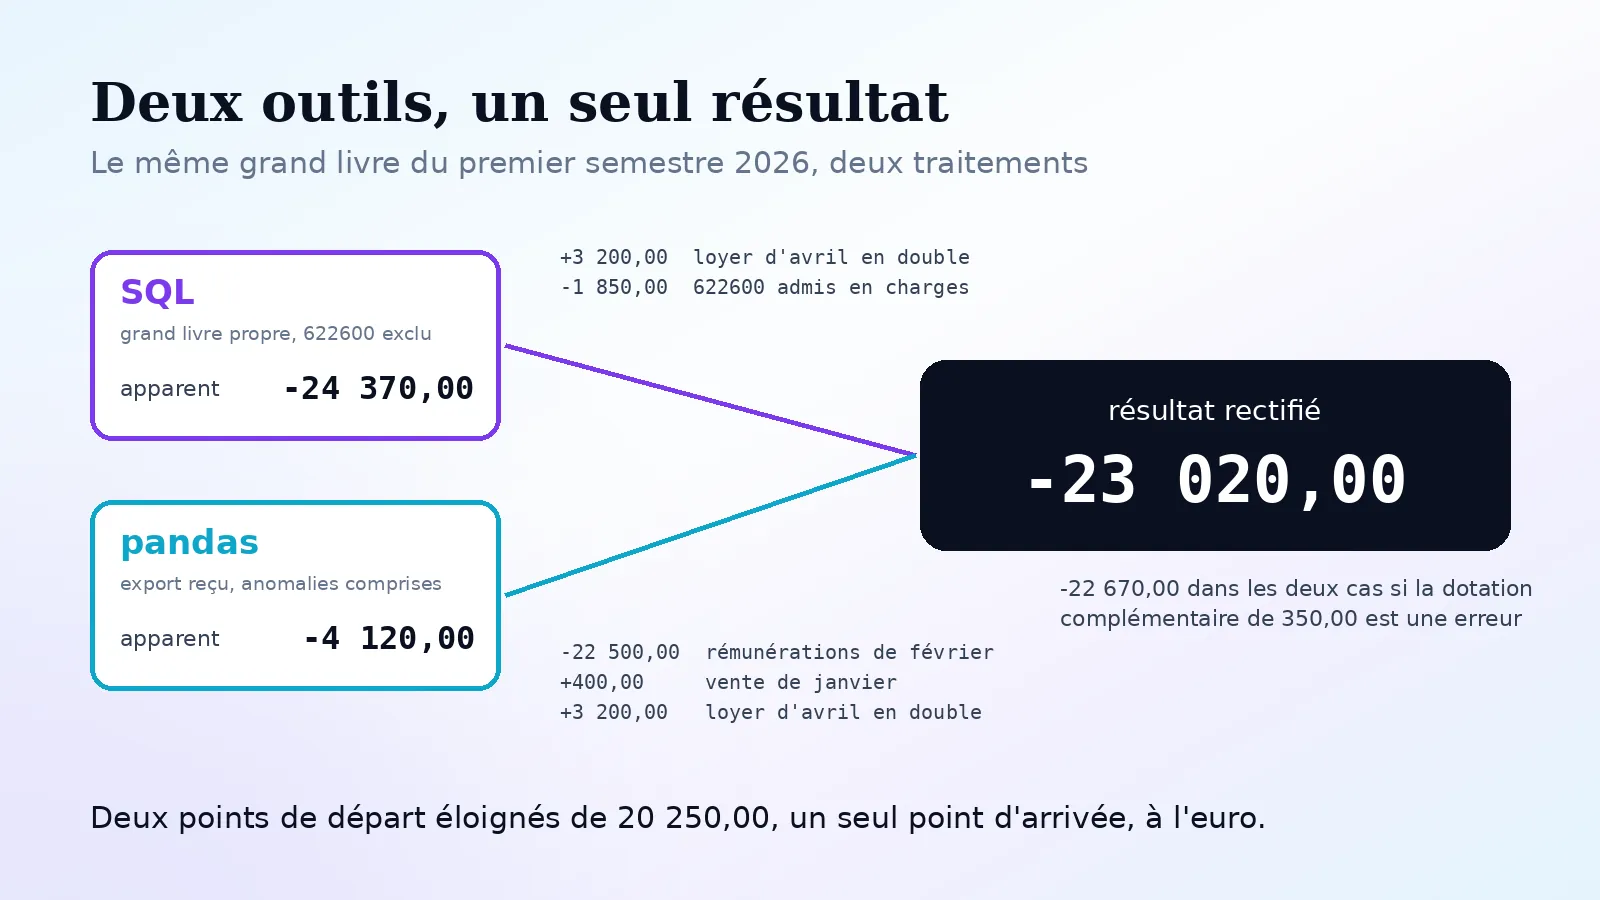
Une réserve reste ouverte : la dotation complémentaire de 350,00 au 31/05/2026. Si c'est une écriture à qui il manque seulement sa contrepartie, le résultat ne bouge pas. Si la ligne elle-même est une erreur, le résultat rectifié passe à -22 670,00, là encore le chiffre obtenu en SQL. La décision appartient à celui qui détient la pièce.
Exporter le livrable, réserves comprises
Le cas
Le destinataire ouvrira les fichiers dans Excel. Ils doivent s'ouvrir au format français, sans colonne d'index parasite, et les réserves doivent voyager avec les chiffres.
La démarche
- Créer un dossier de sorties, distinct du dossier des fichiers reçus.
- Exporter avec le point-virgule comme séparateur, la virgule décimale et
index=False. - Utiliser l'encodage
utf-8-sig: Excel reconnaît alors les accents à l'ouverture. - Exporter la balance, le récapitulatif par classe, les réserves et les doubles à examiner.
from pathlib import Path

sorties = Path("sorties")
sorties.mkdir(exist_ok=True)
options = dict(sep=";", decimal=",", index=False, encoding="utf-8-sig")

balance.to_csv(sorties / "balance_2026_s1.csv", **options)
par_classe.to_csv(sorties / "balance_par_classe.csv", **options)
reserves.to_csv(sorties / "reserves_sur_resultat.csv", **options)
a_examiner.to_csv(sorties / "doublons_a_examiner.csv", **options)

sorted(p.name for p in sorties.iterdir())
Ce que vous devez obtenir
| Fichier | Contenu |
|---|---|
| balance_2026_s1.csv | 18 comptes, dont 3 marqués « compte absent du plan comptable » |
| balance_par_classe.csv | 5 classes |
| reserves_sur_resultat.csv | 3 réserves, effet total -18 900,00 |
| doublons_a_examiner.csv | 6 lignes, dont le loyer d'avril saisi deux fois |
Les erreurs qui coûtent une soirée
- Joindre le plan comptable en interne. Trois comptes disparaissent, une classe entière avec eux, et la balance cesse d'égaler l'écart sans le moindre message.
- Laisser un libellé vide pour un compte inconnu. Dans un tableau croisé, un vide se range avec les autres vides et ne se remarque plus.
- Livrer le résultat apparent sans ses réserves. Le lecteur prend une perte de 4 120,00 pour un chiffre, alors que la perte rectifiée est de 23 020,00.
- Corriger les données pour que le résultat « tombe juste ». On obtient un chiffre, et l'on perd la preuve de la façon dont on l'a obtenu.
- Oublier
index=Falseà l'export. Une colonne de numéros de ligne apparaît dans le livrable. - Exporter en UTF-8 simple pour un lecteur sous Excel. Les accents des libellés arrivent illisibles.
Le traitement est complet : un fichier reçu, lu sans le modifier, converti colonne par colonne, contrôlé jusqu'à l'euro, et livré avec ses réserves. Le même grand livre, traité en SQL puis en pandas, donne le même résultat rectifié. C'est la seule preuve qui compte devant quelqu'un qui demande d'où vient un chiffre.
Pour reprendre la série depuis la lecture du fichier : Le montant qui n'était pas un nombre.
Versions : article rédigé et vérifié avec Python 3.13, pandas 2.3.3 et pandas 3.0.6 ; les chiffres sont identiques dans les deux versions. Les noms de paramètres peuvent évoluer au fil des versions.