L'écart qu'on décompose à l'euro
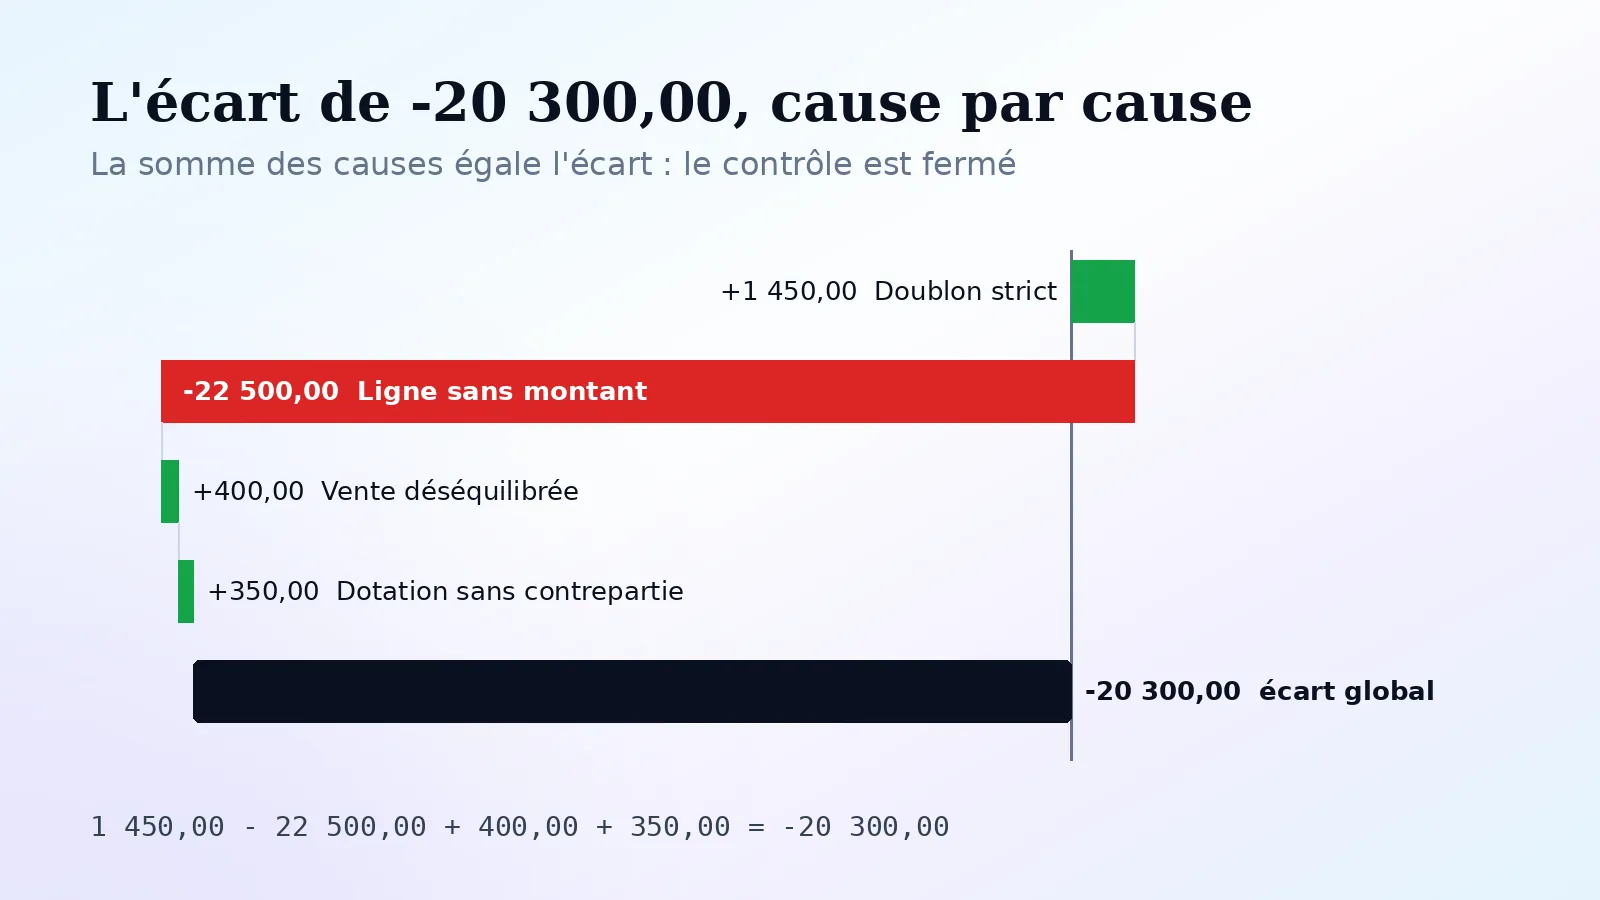
Une balance à -20 300,00 ne se rectifie pas : elle se décompose. Quatre causes chiffrées, un doublon équilibré invisible, trois comptes hors plan.
Dans le cadre de la rubrique « Je partage mes connaissances », je vous propose de reprendre le grand livre du premier semestre 2026 là où nous l'avons laissé : 174 lignes lues avec pandas, des dates et des montants enfin utilisables, et une balance qui ne tombe pas. L'écart est de -20 300,00. Il ne s'agit pas de le faire disparaître, mais de l'expliquer à l'euro près, cause par cause, avant que quiconque ne touche à la comptabilité.
Les fichiers du cas - série Python pour la finance
Le point de départ est le tableau gl obtenu dans Le montant qui n'était pas un nombre : les six colonnes d'origine, plus date, debit_num, credit_num et le drapeau sans_montant.
Pourquoi on ne corrige pas encore
Le réflexe, devant une balance qui ne tombe pas, c'est de chercher la ligne fautive et de la rectifier. Sur un export reçu, c'est la pire décision : on efface la trace de ce qui s'est passé, et l'on ne peut plus expliquer le chiffre à celui qui l'a produit.
La démarche inverse tient en trois gestes : rendre les clés comparables sans toucher à la source, regarder ce qui est en double, puis décomposer l'écart jusqu'à ce que la somme des causes égale l'écart. Corriger reste une décision de gestion. Elle se prend après, et pas dans un script.
Un contrôle se ferme en décomposant l'écart, jamais en le faisant disparaître.
Normaliser à côté, jamais dessus
Le cas
Le même libellé existe sous plusieurs formes : « Achats matières premières janvier 2026 », « ACHATS MATIÈRES PREMIÈRES JANVIER 2026 », en minuscules, avec un double espace. Et 16 lignes portent un compte exporté en 401000.0. Tant que ces clés diffèrent, rien ne se regroupe correctement.
La démarche
- Écrire une fonction de normalisation : accents retirés, majuscules, espaces multiples réduits à un seul.
- L'appliquer dans une nouvelle colonne,
libelle_norm. La colonne d'origine ne bouge pas. - Retirer le suffixe
.0des numéros de compte, sans jamais les convertir en nombre. - Vérifier que chaque compte fait désormais six chiffres.
- Compter les valeurs distinctes, avant et après.
import unicodedata

def normaliser(texte):
    if pd.isna(texte):
        return ""
    sans_accent = (unicodedata.normalize("NFKD", str(texte))
                   .encode("ascii", "ignore").decode("ascii"))
    return " ".join(sans_accent.upper().split())

gl["libelle_norm"] = gl["libelle"].map(normaliser)
gl["compte_net"] = gl["compte"].str.strip().str.replace(r"\.0$", "", regex=True)

gl["compte_net"].str.fullmatch(r"\d{6}").all()
gl["libelle"].nunique(), gl["libelle_norm"].nunique()
gl["compte"].nunique(), gl["compte_net"].nunique()
Ce que vous devez obtenir
| Contrôle | Valeur attendue |
|---|---|
| Comptes exportés en flottant | 16 lignes |
| Comptes à six chiffres après nettoyage | 174 sur 174 |
| Libellés distincts, tels qu'exportés | 153 |
| Libellés distincts après normalisation | 87 |
| Comptes distincts, tels qu'exportés | 27 |
| Comptes distincts après nettoyage | 18 |
Le gain n'est pas cosmétique. Regroupées sur le libellé brut, les lignes du semestre font apparaître 134 écritures déséquilibrées, parce que la ligne de débit et la ligne de crédit d'une même opération ne portent pas la même casse. Sur le libellé normalisé, il en reste 6. Les 128 autres n'étaient que du bruit de saisie.
Le doublon qu'on regarde avant de le supprimer
Le cas
Deux lignes sont strictement identiques : même compte, même date, même journal, même libellé, mêmes montants. Avant de supprimer quoi que ce soit, il faut les voir. Deux règlements du même montant, le même jour, au même fournisseur, peuvent être parfaitement légitimes.
La démarche
- Chercher les doublons stricts sur les colonnes d'origine : un doublon se prouve sur ce qui a été reçu.
- Utiliser
keep=Falsepour afficher les deux exemplaires, pas seulement le second. - Regarder, puis décider. Ici, même compte, même jour, même libellé, même montant : c'est une double saisie.
- Dédoublonner dans un nouveau tableau,
net. Le tableauglgarde ses 174 lignes. - Refaire la recherche sur les colonnes normalisées, pour les saisies doubles qui ne se ressemblent pas à la source. Ce qu'elle trouve se regarde et se signale ; rien n'est supprimé.
colonnes = ["compte", "date_ecriture", "journal", "libelle", "debit", "credit"]
doublons = gl[gl.duplicated(subset=colonnes, keep=False)].sort_values(colonnes)
net = gl.drop_duplicates(subset=colonnes, keep="first").copy()
len(doublons), len(net), len(gl)

cles = ["compte_net", "date", "journal", "libelle_norm", "debit_num", "credit_num"]
a_examiner = gl[gl.duplicated(subset=cles, keep=False)].sort_values(cles)
len(a_examiner)
Ce que vous devez obtenir
| Contrôle | Valeur attendue |
|---|---|
| Doublon strict | 2 lignes : compte 606100, 31/01/2026, ACH, 1 450,00 au débit |
| Lignes après dédoublonnage | 173 |
Lignes de gl | 174, inchangé |
| Doubles sur les colonnes normalisées | 6 lignes : les 2 ci-dessus, plus 4 |
| Écart débit moins crédit, 174 lignes | -20 300,00 |
| Écart, 173 lignes | -21 750,00 |
L'écart grandit quand on retire le doublon, et c'est normal : la ligne en double ajoutait 1 450,00 de débit sans crédit en face. Un écart qui « s'améliore » quand on retire une ligne ne prouve rien ; un écart dont on sait expliquer chaque variation, si.
Les 4 lignes de plus méritent qu'on s'y arrête. C'est le loyer d'avril, saisi deux fois avec ses deux jambes : 3 200,00 au débit de 613000 et au crédit de 512000, une fois daté 30/04/2026, une fois 2026-04-30, avec une casse différente. La comparaison stricte ne peut pas le voir : à la source, les deux saisies ne se ressemblent pas. Et l'écart ne le trahira jamais, puisque ses deux jambes s'annulent. La charge de loyer du semestre est pourtant surévaluée de 3 200,00. C'est le même loyer d'avril que le rapprochement bancaire en SQL ne voyait pas dans Le doublon que le rapprochement ne voyait pas.
Un doublon équilibré ne se voit pas dans l'écart. Il se cherche sur des clés comparables, et il se signale avec sa pièce, il ne se supprime pas sans elle.
Décomposer l'écart à l'euro
Le cas
L'export n'a pas de numéro de pièce. Pour vérifier l'équilibre écriture par écriture, il faut reconstituer une clé : la date, le journal et le libellé normalisé. Tout groupe dont le débit diffère du crédit est une piste.
La démarche
- Calculer l'écart global, avant et après dédoublonnage.
- Regrouper par date, journal et libellé normalisé, puis garder les groupes dont l'écart n'est pas nul.
- Qualifier chaque groupe, un par un.
- Écrire la décomposition, et la faire vérifier par la machine plutôt que par soi.
def ecart(cadre):
    return round(cadre["debit_num"].sum() - cadre["credit_num"].sum(), 2)

ecart(gl), ecart(net)

cle = ["date", "journal", "libelle_norm"]
par_ecriture = gl.groupby(cle)[["debit_num", "credit_num"]].sum()
par_ecriture["ecart"] = (par_ecriture["debit_num"] - par_ecriture["credit_num"]).round(2)
desequilibrees = par_ecriture[par_ecriture["ecart"] != 0].reset_index()
len(desequilibrees)

assert round(1450.00 - 22500.00 + 400.00 + 350.00, 2) == ecart(gl)
Ce que vous devez obtenir
| Cause | Montant | Où |
|---|---|---|
| Doublon strict | +1 450,00 | 606100, 31/01/2026, ACH |
| Ligne sans montant | -22 500,00 | 641000, 28/02/2026, PAIE |
| Vente déséquilibrée | +400,00 | 31/01/2026, VTE : 38 200,00 en banque, 37 800,00 en ventes |
| Dotation sans contrepartie | +350,00 | 681000, 31/05/2026, OD |
| Total | -20 300,00 | l'écart global, à l'euro |
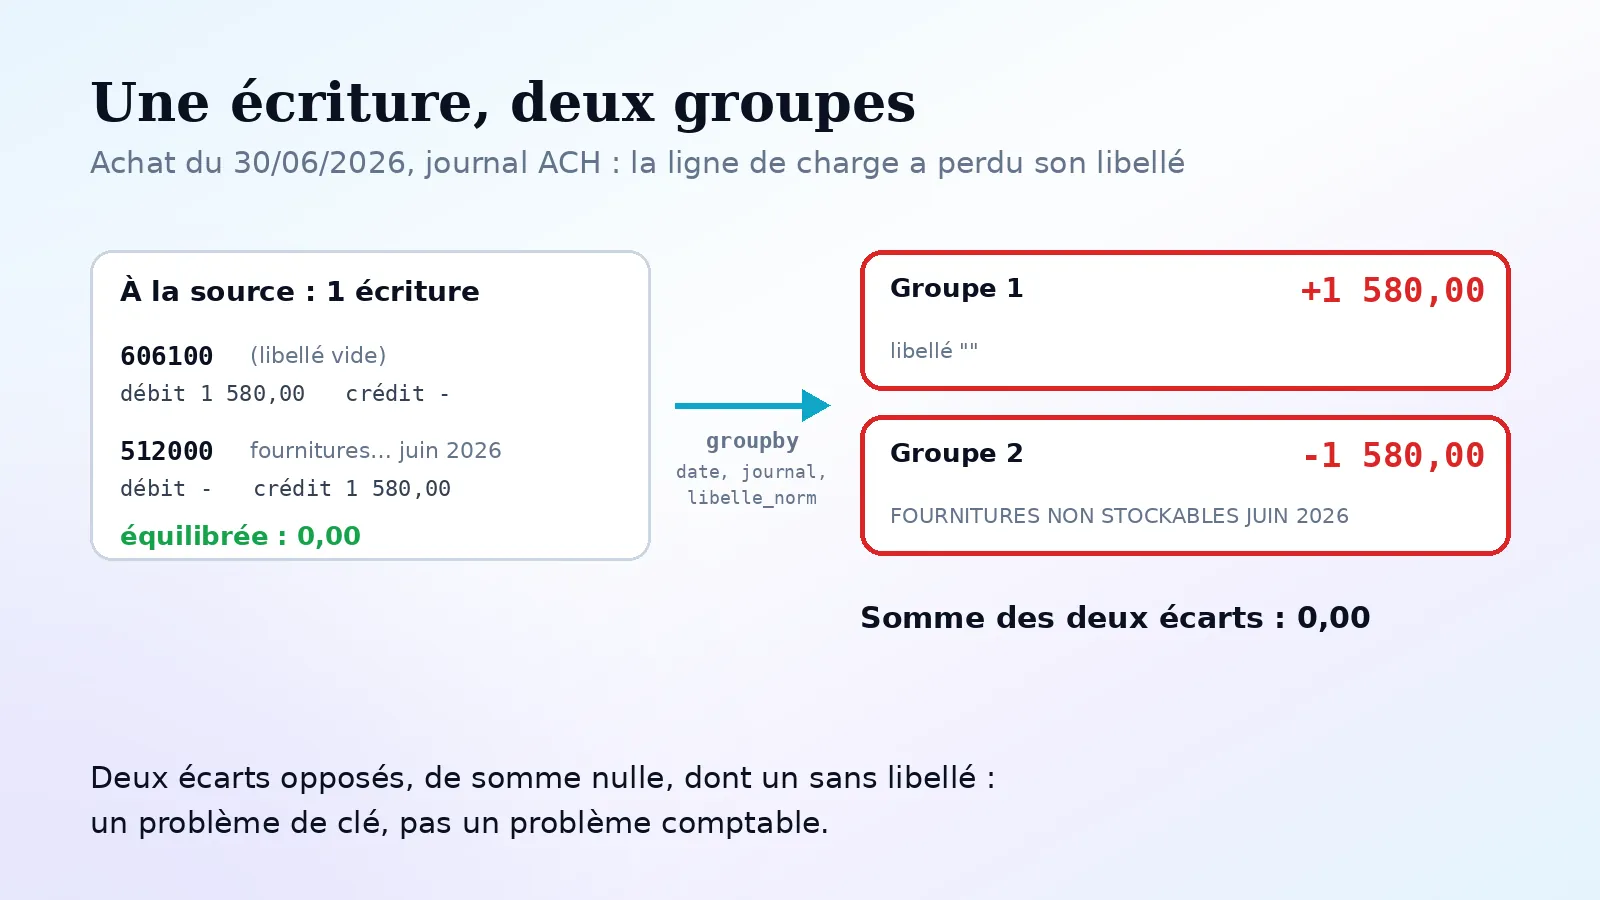
Six groupes ressortent sur les 174 lignes, cinq une fois le doublon retiré. Quatre sont les causes du tableau. Les deux derniers se ressemblent trop pour être une coïncidence : au 30/06/2026, journal ACH, l'un affiche +1 580,00, l'autre -1 580,00, et l'un des deux n'a pas de libellé. C'est une seule écriture d'achat de fournitures, coupée en deux par la clé de regroupement : la ligne de charge a perdu son libellé à l'export, elle ne retrouve plus sa contrepartie en banque.
La dotation complémentaire de 350,00 n'est pas une découverte : elle avait déjà été trouvée en SQL, sur le même grand livre, dans Équilibré et pourtant faux. Deux outils, deux méthodes, le même chiffre : c'est ce qui rend le contrôle crédible.
Deux écarts opposés, de somme nulle, dont l'un sans libellé : c'est un problème de clé, pas un problème comptable.
Les comptes que le plan comptable ne connaît pas
Le cas
Une balance peut encore mentir quand chaque écriture est expliquée : un compte mouvementé absent du plan comptable y suffit. Le contrôle consiste à joindre le grand livre au plan, et à lister ce qui ne trouve pas de correspondance.
La démarche
- Lire le plan comptable en texte, comme le grand livre.
- Joindre en
how="left", avecindicator=True: chaque ligne du grand livre est conservée, et une colonne dit si elle a trouvé son compte. - Lister les comptes marqués
left_only.
plan = pd.read_csv("plan_comptable.csv", dtype=str, encoding="utf-8")
plan["Compte"] = plan["Compte"].str.strip()

verif = net.merge(plan[["Compte"]].rename(columns={"Compte": "compte_net"}),
                  on="compte_net", how="left", indicator=True)
sorted(verif.loc[verif["_merge"] == "left_only", "compte_net"].unique())
Ce que vous devez obtenir
| Compte | Ligne | Montant |
|---|---|---|
| 281000 | 30/04/2026, BQ, charges d'intérêts | 900,00 au crédit |
| 622600 | 31/03/2026, ACH, honoraires comptables | 1 850,00 au débit |
| 627000 | 30/04/2026, BQ, charges d'intérêts | 900,00 au débit |
Une jointure interne aurait fait disparaître ces trois lignes sans le moindre message. L'écart serait passé de -21 750,00 à -23 600,00, et les 1 850,00 de différence n'auraient été attribués à rien. Le compte 622600 vient du grand livre d'origine : c'est lui que la jointure SQL faisait disparaître dans Le compte que la jointure faisait disparaître. Le retrouver ici, après toutes les transformations, prouve que la chaîne de traitement n'a rien perdu.
Une anomalie de données se signale à celui qui saisit. Une anomalie de référentiel se signale à celui qui tient le plan comptable. Ce ne sont pas les mêmes personnes.
Les erreurs qui coûtent une soirée
- Normaliser en écrasant le libellé d'origine. On ne peut plus justifier un regroupement à celui qui ne connaît que le libellé reçu.
- Convertir les numéros de compte en entiers pour retirer le
.0. Cela fonctionne, jusqu'au premier compte à zéro de tête. - Supprimer un doublon sans l'avoir regardé. Deux paiements identiques le même jour existent.
- S'arrêter à la comparaison stricte. Une double saisie sous deux formes passe à travers, et si elle est équilibrée, l'écart ne la trahira jamais.
- Grouper sur un libellé saisi à la main sans le normaliser. 134 écritures déséquilibrées au lieu de 6, et les vraies se perdent dans le bruit.
- Joindre le plan comptable en interne. Les comptes inconnus disparaissent, et l'écart change sans explication.
À ce stade, rien n'a été rectifié, et tout est expliqué : quatre causes chiffrées, un doublon équilibré à signaler, trois comptes hors référentiel, un artefact de clé. Reste à produire le livrable : une balance où les comptes inconnus apparaissent au lieu de disparaître, et un rapport d'anomalies livré avec les chiffres. C'est l'objet de l'article suivant.
Pour la lecture des dates et des montants qui précède : Le montant qui n'était pas un nombre.
Versions : article rédigé et vérifié avec Python 3.13, pandas 2.3.3 et pandas 3.0.6 ; les chiffres sont identiques dans les deux versions. Les noms de paramètres peuvent évoluer au fil des versions.